
Maillage interne SEO : faire circuler la popularité dans votre site
Par Quentin Blanchon
Publié le :
4 minutes
SEO e-commerce & B2B · Contenu
Crawler un site web consiste à le parcourir avec un robot d'exploration qui suit les liens comme le fait Googlebot. Le crawl dresse l'inventaire de toutes les URL avec leurs données SEO : code de réponse, indexabilité, balises, profondeur, liens. Il sert à détecter et prioriser les erreurs techniques, et à préparer une refonte ou une migration en récupérant l'existant.
Crawler un site web consiste à l'explorer avec un logiciel qui imite le comportement des robots des moteurs de recherche, comme Googlebot. Pour l'expert SEO, c'est le point de départ de tout diagnostic technique.
Pourquoi crawler son site régulièrement ? Au fil des ajouts de pages et des mises à jour, les erreurs s'accumulent : liens cassés, pages en double, balises manquantes. Un crawl permet de les identifier avant qu'elles ne freinent l'exploration et le classement de vos pages.
Le robot part d'une URL, suit les liens du site comme le ferait un visiteur, et récupère le code de chaque page. Il obtient ainsi une photographie complète du site à un instant donné. Une technique voisine, le scraping, sert à extraire les contenus d'un site pour préparer une migration ou une refonte.
Le crawl relève du SEO technique. Son objectif est d'établir une image fidèle du site : sa structure, son profil de liens internes et ses problèmes techniques. Ce sont les robots, aussi appelés crawlers ou spiders, qui réalisent cette exploration.
Le logiciel de crawl visite les URL du site ainsi que les ressources associées (fichiers CSS, JavaScript, images). Les outils actuels savent aussi exécuter le JavaScript, ce qui est indispensable pour les sites dont le contenu s'affiche côté navigateur. Il vérifie les liens sortants sans explorer les sites externes, puis rassemble toutes ces données dans un tableau exportable (CSV, Excel ou rapports intégrés).
Un crawl permet de détecter des problèmes d'arborescence, des pages bloquées par le fichier robots.txt ou une balise noindex, et des erreurs de toutes sortes. Il aide aussi à optimiser le budget de crawl, c'est-à-dire le temps que Google consacre à explorer votre site.
Ce dernier point concerne surtout les sites volumineux, comme les e-commerces à plusieurs milliers de pages. L'idée est que Googlebot passe son temps sur les pages utiles, et non sur des URL de filtres, des doublons ou des pages sans intérêt pour la recherche.
En une seule exploration, le crawler fournit des informations détaillées pour chaque URL : code de réponse HTTP, statut d'indexabilité, balise canonical, nombre de mots, poids des ressources, liens entrants et sortants. Les outils proposent ensuite une vue de synthèse des problèmes détectés. Deux grandes familles de données intéressent le SEO.
Un crawl standard mesure le temps de réponse de chaque page. C'est un premier indicateur, mais il ne remplace pas les Core Web Vitals : pour les mesurer, on connecte le crawler à PageSpeed Insights, ou on consulte le rapport dédié de la Search Console, qui s'appuie sur des données d'utilisateurs réels.
Le crawl remonte aussi les redirections (3xx) et les erreurs (4xx, 5xx) URL par URL. Il indique le nombre de pages indexables et liste les pages dont les balises title ou meta description sont absentes ou dupliquées.
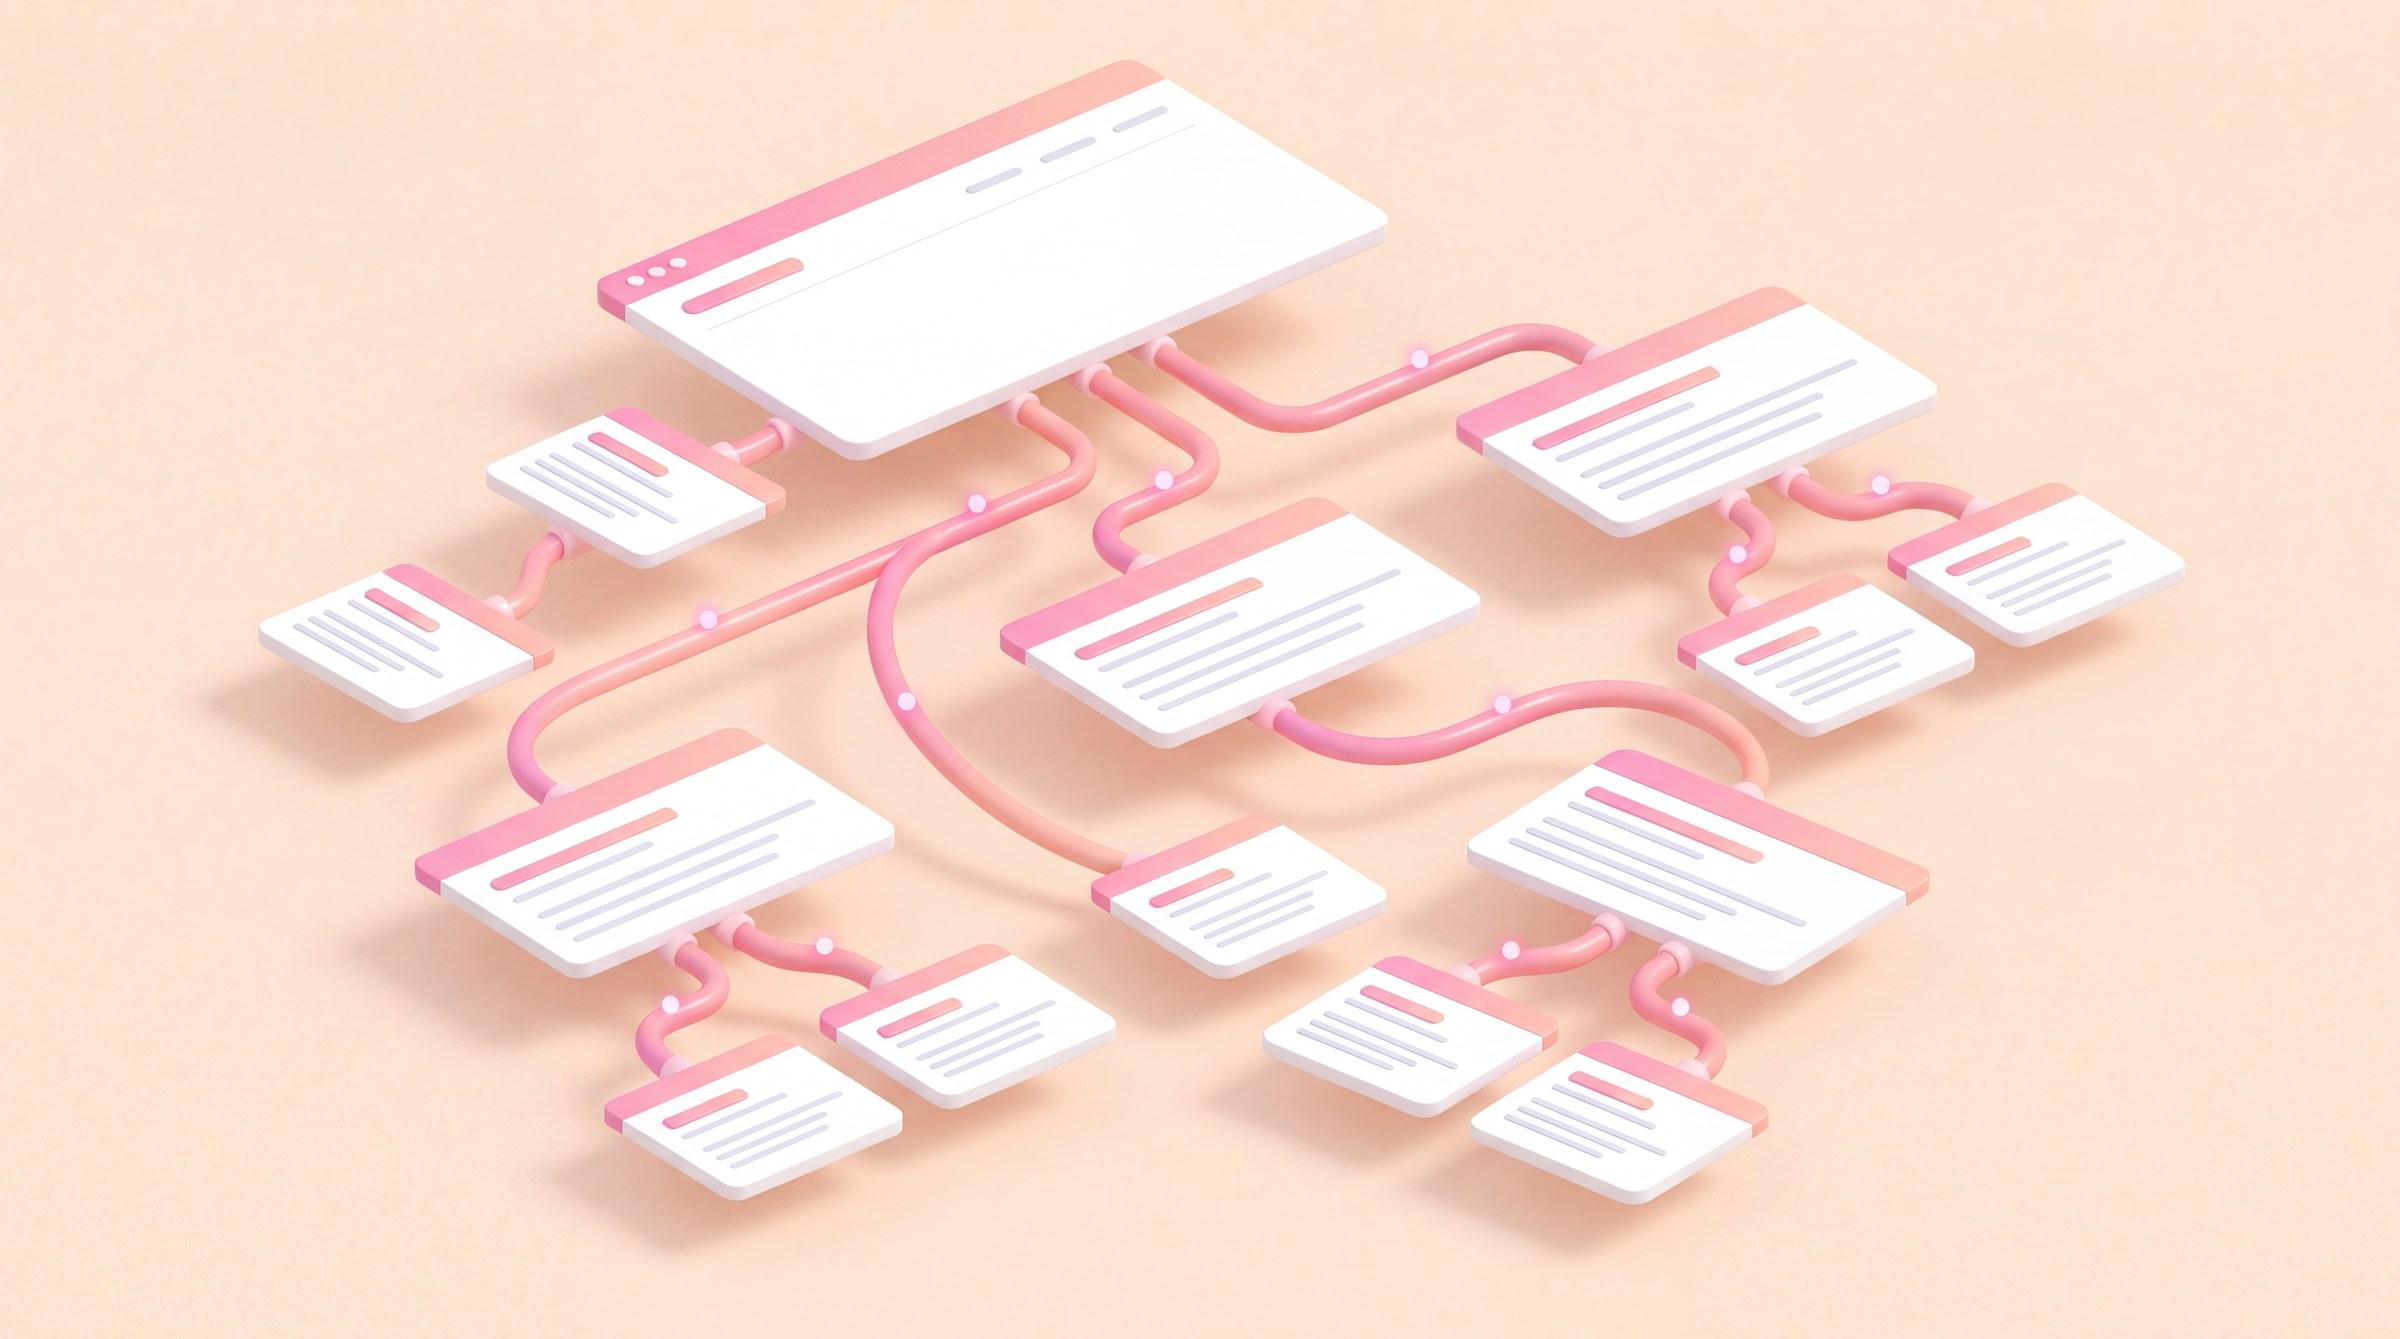
Le crawler mesure la profondeur de chaque page : le nombre de clics nécessaires pour l'atteindre depuis la page d'accueil. Plus une page est profonde, moins elle reçoit de popularité interne et moins elle est explorée souvent.
Il signale aussi les problèmes de balisage (title trop longs ou trop courts, H1 manquant ou multiple, voir notre article sur les balises meta) et les problèmes de liens : liens en nofollow vers des pages internes, ancres non descriptives, liens vers des pages redirigées.
Une fois le crawl terminé, les données se lisent en croisant plusieurs critères :
Croisées avec les données de la Search Console (impressions, clics, pages exclues de l'index), ces informations montrent quelles pages comptent réellement et lesquelles posent problème.
Le crawl identifie les obstacles que rencontrent les robots des moteurs de recherche, et la plupart des outils indiquent un niveau de priorité pour chaque problème. Temps de réponse trop long, erreurs 404, balises dupliquées font partie des corrections courantes.
Les résultats permettent de réparer les liens internes cassés, de traiter les pages vides ou quasi vides que Google considère comme des erreurs 404 « soft », et de repérer les pages orphelines. Ils facilitent aussi la construction d'une arborescence plus courte et d'un fichier robots.txt cohérent, pour une meilleure indexation.
Le scraping est une technique voisine du crawl : il consiste à extraire des données précises de chaque page. Il sert notamment à préparer une refonte de site ou un changement de CMS.
L'outil se configure pour extraire les éléments voulus, à l'aide d'expressions XPath, de sélecteurs CSS ou d'expressions régulières (regex). Pour migrer un site vers un nouveau CMS, on récupère par exemple le H1, le contenu principal, la balise title et la meta description de chaque page. Le même crawl fournit la liste des URL qui servira au plan de redirection.
Chez Strent, le crawl est la première étape de chaque audit technique et de chaque refonte : inventaire des URL, priorisation des erreurs, recommandations et contrôle après correction. Vous voulez savoir ce que Google voit vraiment de votre site ? Contactez-nous pour une étude gratuite.